Антоний Казанский#: Тогда пожалуйста разверните более доходчиво свою мысль и лучше на живых примерах, чтобы стало понятно, каким образом вы предлагаете программно уникализировать тысячи страниц с помощью 3-5 предложений.
Алиэкспресс.(Результатов: примерно 81 900 000(0,47 сек.)) и это только по моей локации. Китайских братьев, конечно много, некоторые за пайку риса работают, но неужели Вы думаете, что они каждое описание ручками делают? Кстати, к своим ошибкам они тоже нормально относятся (со здоровым пофигизмом), по площадям бьют. Да и не зацикливайтесь на количестве. Имелось ввиду для каждой стр. Методы генерации для каждой ниши свои. Тут желательная своя, индивидуальная изюминка для неповторимой, качественной генерации.
Виктор Петров#: Так что да, многое упирается в своего рода "карму" сайта
Это всё софистика. Слушайте больше дружище Мюллера и его друганов. Они говорят лишь то, что им дозволено сказать. Так сказать официальную позицию. И это правильно, я бы и сам так делал.
Включите свою логику - никто не любит долго ждать и напрягаться. Ни гуглобот, ни пользователи (для кого вся эта каша заваривается), ни ленивые разрабы.
А, может и правда у ТС банально проблемы с откликом? Он вроде ни словом об этом не обмолвился. Но это я так, в порядке общего бреда.
Вообще я не хочу хвалиться, но каждый запрос ходовой профилирую и анализ EXPLAIN делаю. Где надо ставлю индексы, где не надо убираю и т.д., стараюсь уменьшить длину ключа, не делать лишних запросов, провожу нормализацию/денормализацию данных (не всегда удачно, правда) т.к. каждая мсек у меня на счету.
Вообще на больших данных не ошибки неизбежны. Инженерная точность 10%. Если ошибки в этом пределе - стараюсь не замечать проблемы, откладываю на потом, иду дальше не зацикливаясь.
По моему, чем более оптимизировано информационное обеспечение, тем лучше всем - и процессор меньше напрягается, не выполняя левых команд, и гуглобот меньше ждёт своей очереди, и пользователь (что самое главное), да и мне быстрее отлаживать.
Потому что не всё упирается в контент. Гуглобот технически имеет ограничения на обход сайта. Вот он получил документ - вот он получил с этого документа список ссылок, которые поставил в очередь на дальнейший обход. И приоритет этим ссылкам он отдаст разный, в соответствии со своими собственными алгоритмами.
По своему опыту, тут время отклика имеет значение. Долго ждать он не любит. Ну а когда дойдёт очередь - он может съесть много, если конечно его принудительно не глушат. Если содержание его заинтересует - плевать он хотел на ограничения.
Не думаю, что всё так плохо. Такие сайты вытягивать можно и нужно. Тут я вижу пока 2 пути.
Ждать пока всё наладится (если контента на страницах мало и он не уникальный, ждать можно до бесконечности).
Проявить лёгкое творчество и расширить/уникализировать содержание. Потому, что серых однообразных страниц у гугла и так в достатке. Ему надо, что-то новенькое, свежее, не стандартное. Например, сгенерировать немного (параграфа из 3-5 предложений, думаю, будет достаточно, главное не переборщить) уникального релевантного контента. Если не сильны в программировании, можно попросить программистов (отблагодарить в таком случае, безусловно нужно знатно и не скупиться, а то всё прахом пойдёт, а оно вам надо?). Но это так, на свой страх и риск, сами понимаете. Как минимум на короткой дистанции должно помочь. А если некачественно нагенерируете, то через пару месяцев может прилететь глухой бан. Тогда будет несколько сложнее. Но тоже поправимо.
В любом случае не стоит опускать руки и слушать всепропальщиков-теоретиков. У меня таких страниц в разы больше и ничего, живу.
Многие из тех, которые без ошибок долгое время были не проиндексированы, просто отлёживались, ждали своего времени, многие доси ждут.
Дарвин#: А что значит "собственный айпишник"? Нет ай-пи адреса? На одном сайте тоже есть подобная ситуация, добавил адреса в бан, но периодически приходится добавлять новые, так как атака идет в виде серфинга.
А что значит "атака идет в виде серфинга."? В чём суть, цель и замысел атаки?



Подскажите, пожалуйста, как построить такой график?
https://search.google.com/search-console/settings/crawl-stats (не знаю сработает ссылка или нет)
Настройки > Статистика сканирования
человек 10 тыщ страничек разом влил
Это пыль для гугла. Вы краулинговый бютжет рассматриваете только в контексте дискового пространства?
А я ещё рассматриваю как бюджет реального времени.
Тогда пожалуйста разверните более доходчиво свою мысль и лучше на живых примерах, чтобы стало понятно, каким образом вы предлагаете программно уникализировать тысячи страниц с помощью 3-5 предложений.
Так что да, многое упирается в своего рода "карму" сайта
Это всё софистика. Слушайте больше дружище Мюллера и его друганов. Они говорят лишь то, что им дозволено сказать. Так сказать официальную позицию. И это правильно, я бы и сам так делал.
Включите свою логику - никто не любит долго ждать и напрягаться. Ни гуглобот, ни пользователи (для кого вся эта каша заваривается), ни ленивые разрабы.
А, может и правда у ТС банально проблемы с откликом? Он вроде ни словом об этом не обмолвился. Но это я так, в порядке общего бреда.
Вообще я не хочу хвалиться, но каждый запрос ходовой профилирую и анализ EXPLAIN делаю. Где надо ставлю индексы, где не надо убираю и т.д., стараюсь уменьшить длину ключа, не делать лишних запросов, провожу нормализацию/денормализацию данных (не всегда удачно, правда) т.к. каждая мсек у меня на счету.
Вообще на больших данных не ошибки неизбежны. Инженерная точность 10%. Если ошибки в этом пределе - стараюсь не замечать проблемы, откладываю на потом, иду дальше не зацикливаясь.
По моему, чем более оптимизировано информационное обеспечение, тем лучше всем - и процессор меньше напрягается, не выполняя левых команд, и гуглобот меньше ждёт своей очереди, и пользователь (что самое главное), да и мне быстрее отлаживать.
Сгенерировать из 3-5 предложений уникального контента почти на 10K товарных страниц? :) Вы верно шутите.
нет. Вы меня не верно поняли.
Пардон за офф-топ: А почему, под сообщениями, какие-то левые ссылки автоматом появляются?
Потому что не всё упирается в контент.
Гуглобот технически имеет ограничения на обход сайта. Вот он получил документ - вот он получил с этого документа список ссылок, которые поставил в очередь на дальнейший обход. И приоритет этим ссылкам он отдаст разный, в соответствии со своими собственными алгоритмами.
год назад
Не думаю, что всё так плохо. Такие сайты вытягивать можно и нужно. Тут я вижу пока 2 пути.
В любом случае не стоит опускать руки и слушать всепропальщиков-теоретиков. У меня таких страниц в разы больше и ничего, живу.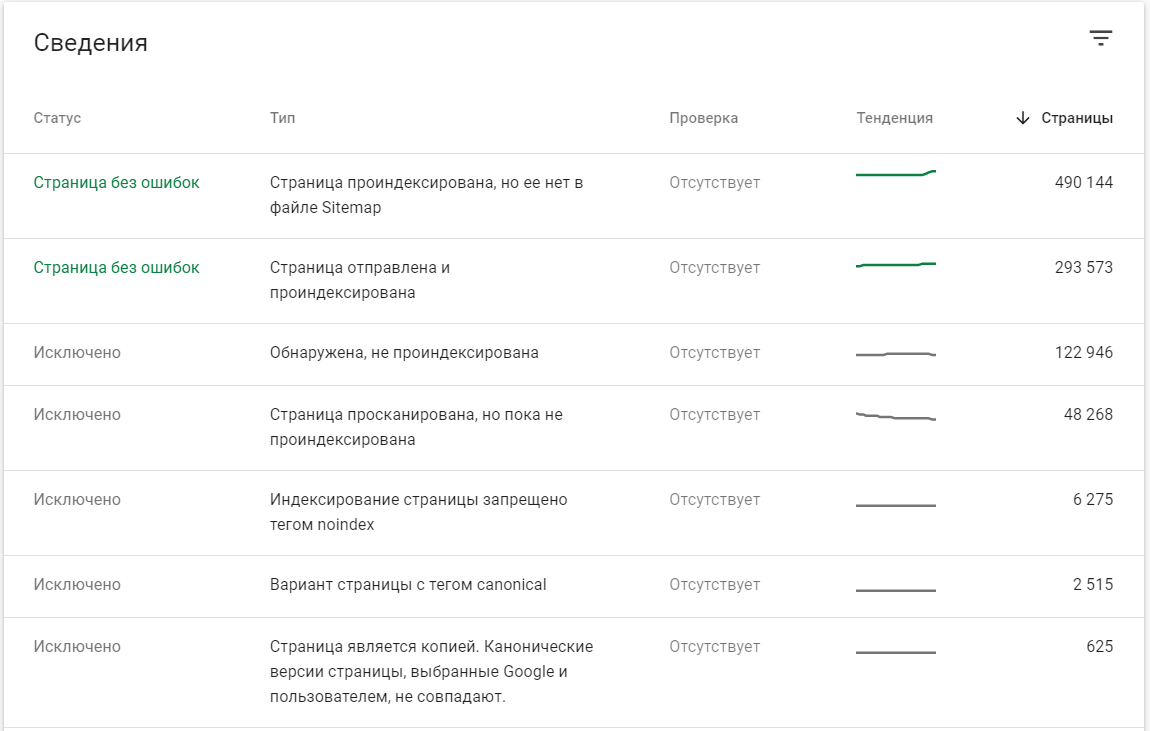
Многие из тех, которые без ошибок долгое время были не проиндексированы, просто отлёживались, ждали своего времени, многие доси ждут.
Так, что крест на них ставить ещё очень рано.
Желаю успехов!
А что значит "собственный айпишник"? Нет ай-пи адреса? На одном сайте тоже есть подобная ситуация, добавил адреса в бан, но периодически приходится добавлять новые, так как атака идет в виде серфинга.
А что значит "атака идет в виде серфинга."? В чём суть, цель и замысел атаки?
Может это сёрфинг в виде атаки?
у всех гугл последние недели плохо индексирует страницы сайта? или у них там опять какие то работы?
а по сайту что делали?